

虚拟细胞大赛冠军揭晓,看Arc如何定义高质量Perturb-seq
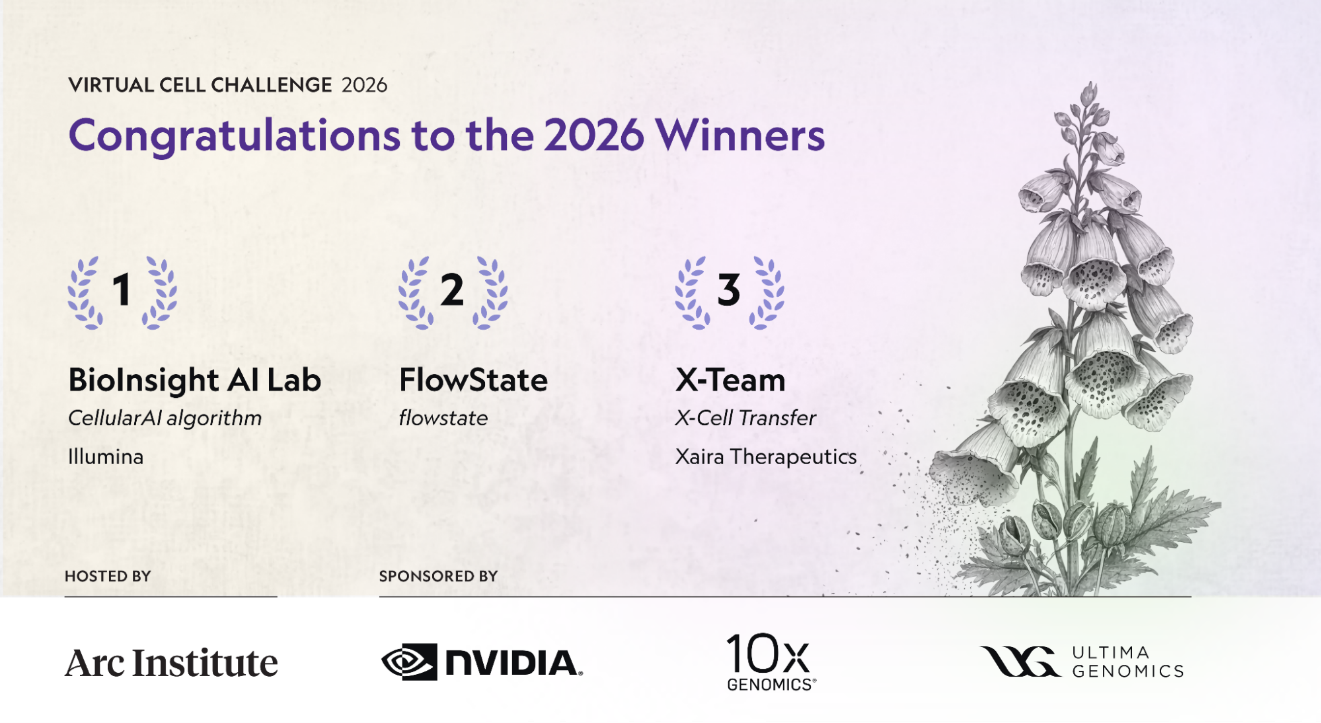
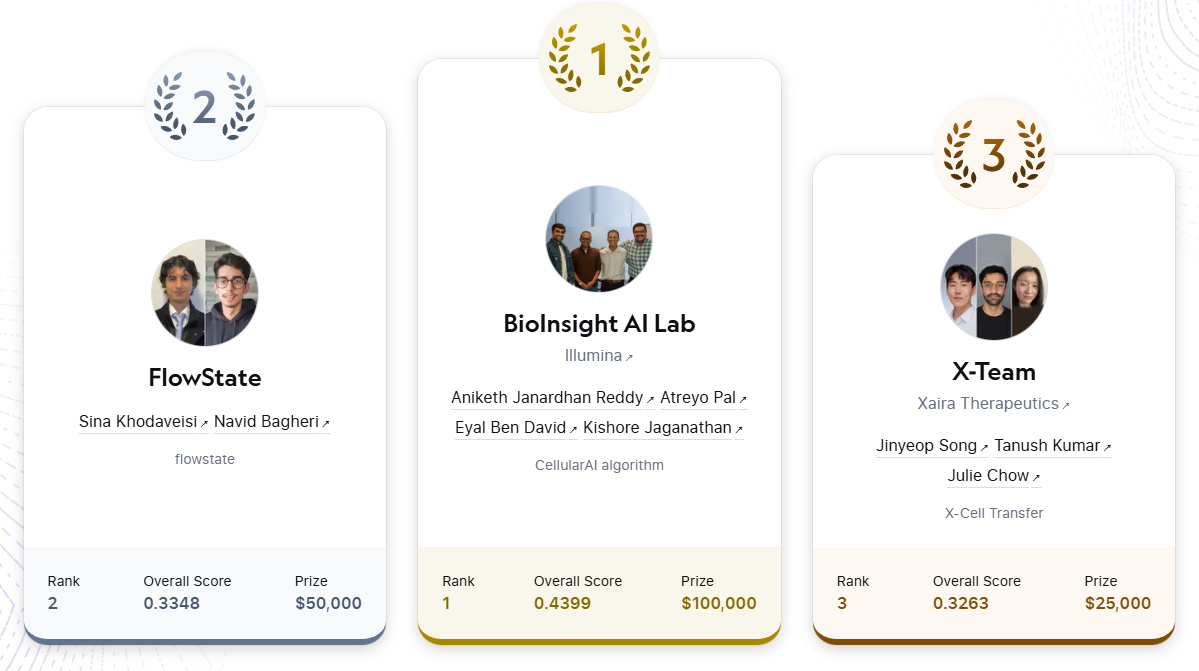
由Arc Institute等机构及公司联合发起的Virtual Cell Challenge 2026(虚拟细胞挑战赛2026)结果已经正式揭晓,来自illumina的BioInsight AI Lab获得了本次的冠军。
事实上Arc在2024年和2025年发起的第一次虚拟细胞挑战赛,得到了来自全球各地许多参赛队伍的积极响应。显然为虚拟细胞后续的路径做了很好的开头作用。Arc一直坚信虚拟细胞模型能够在基因扰动、药物扰动等多个领域创造第一填补空白。
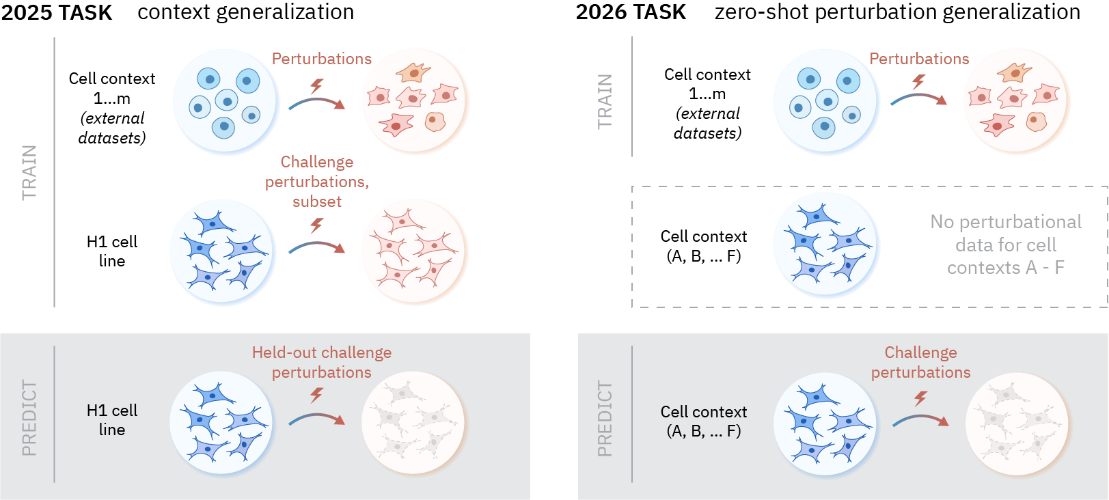
当时使用的是hESC细胞而非永生化细胞系,也仅仅某一种细胞的feature特征。而在2026年,Arc将细胞系增加到了6种,并且并未公布细胞系的种类。
由模型去预测实验室中无法大规模进行测试的生物系统中的遗传突变、环境变化和药物治疗的影响,是一个伟大的愿景。目前由于还缺海量的单细胞数据来论证因果关系,以便于模型能够在后期通过学习和训练来预测任何细胞类型对于基因扰动的反应。这就是最初Arc发起虚拟细胞挑战赛的初衷。
讲实话,未来的理想很丰满,但是现实的困难及挑战也不小。虚拟细胞仍有很长的路要走,那么究竟选择何种扰动条件呢?结合当下研究虚拟细胞现实情况,构建大规模的基因扰动数据集是最佳的路径和实现方式之一。这些工作是为了证明虚拟细胞模型首先必须要有海量和广度的单细胞RNA数据,以便于后期能做出更为准确的预测。而一旦涉及到药物扰动、环境扰动等,工作会变得更为复杂。
2026年Arc在虚拟细胞挑战赛中进一步想要推动上下文泛化能力的发展(也叫拓展迁移能力),最终目的是想要直接预测在未观察到的细胞中的扰动效应。因此今年Arc并未公布6种细胞系的种类和名称,但是Arc强调这6种细胞系是精挑细选过的,代表着一定的多样性。
' fill='%23FFFFFF'%3E%3Crect x='249' y='126' width='1' height='1'%3E%3C/rect%3E%3C/g%3E%3C/g%3E%3C/svg%3E)
换句话中,细胞系本身具有各自多样性代表特征,再去进行扰动后,模型的迁移学习能力效果会变得更强。从上图中我们可以看到2025年仅有1个细胞系且知道是hESC,参赛者被Arc提供扰动数据,并要求预测在同一细胞系中未见过的扰动的影响。但是2026年,难度升级了!参赛者仅获得来自6个细胞系的未扰动细胞的转录组数据。
Arc将未经过扰动处理的细胞转录组数据提供给参赛队伍,以及用于评估模型性能的准确的真实扰动数据。Arc为此还专门开发了在不同细胞背景下生成高质量扰动数据的流程。
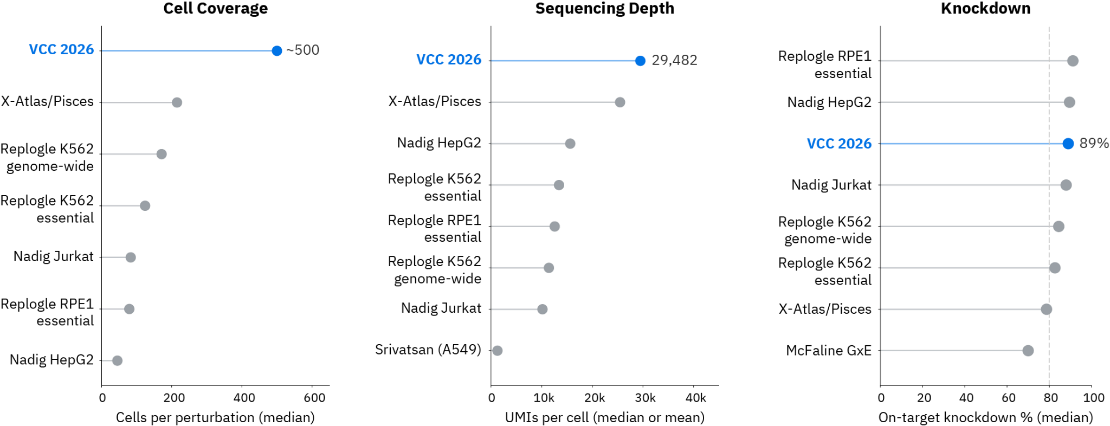
如上图所示,标蓝色的指的是Arc在2026年虚拟细胞挑战赛launch的数据集,简称VCC 2026,并跟其他已公开的Perturb-seq数据集在各种指标多个维度开展比较,无论是细胞重复数量、每个细胞的reads数以及基因敲低的整体效率,本次2026虚拟细胞挑战赛的数据集堪称当前最高质量。
Arc Institute数据集的生成方法依旧是我们所熟知的Perturb-seq(即同时获得细胞中mRNA表达和CRISPR扰动gRNA信息的一种单细胞测序技术)。由于在上一篇推文中,我们已经详细介绍并解释了10x Flex技术和CRISPRi技术,因此本文不再多做赘述。
拓展阅读:构建虚拟细胞的实验路径,标准题库和挑战究竟是什么?
Arc非常严谨在在这6个细胞系中按照同等条件执行了Perturb-seq,并且每个细胞的每条gRNA的扰动效果都开展了系统性的验证,包括递送效率、敲低效率等。此外还在扰动后统一的时间点搜集细胞进行FIX固定。总之Arc尽量将统计学干扰因素控制到最小。
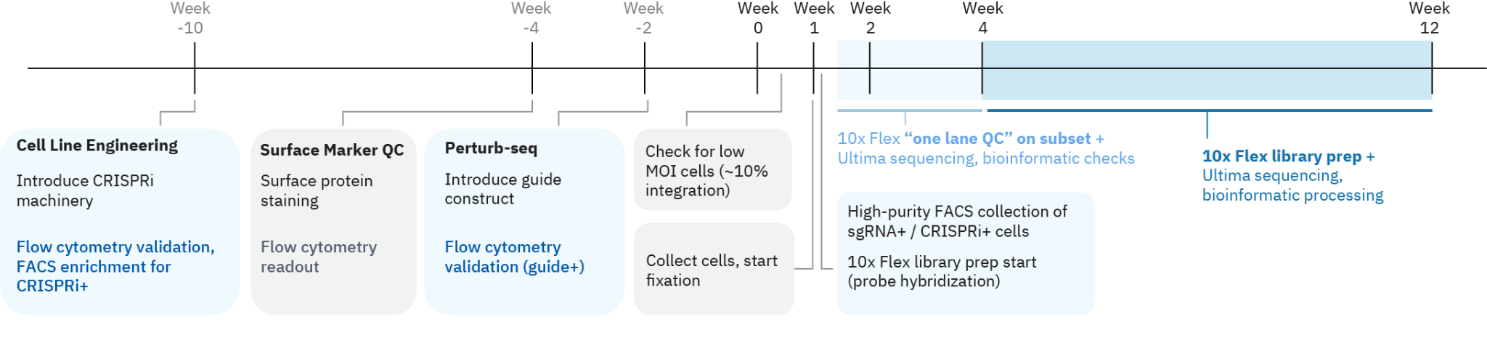
从这张流程图就可以看到,设计一个扰动实验整体周期并不短,包括CRISPRi细胞系工程与验证、筛选执行、实验质量评估、样本收集、细胞分析、测序和数据分析等,总计花费超过22周时间(接近半年时间!)。
这次Perturb-seq实验中,Arc还包含了100个非靶向的sgRNA作为阴性对照,也叫NTCs(non target controls)。由于每条sgRNA至少需要500个细胞重复,因此Arc对定义基线水平的总计50,000个control细胞进行了分析并作为基线参考数据。
这6种细胞系,除了每个细胞系加入了100条NTCs外,Arc还对10,000种扰动超过10亿个细胞进行了分析(换句话说CRISPRi实际预实验sgRNA条数超过了10,000条)。在上一篇2025年发布的虚拟细胞挑战赛中,我们发现300条gRNA囊括了显著扰动效果(strong)、微弱扰动效果(subtle)和无效果(negative)三种不同类型。因此Arc在本次的6个细胞系中最终拿到了3000万个细胞由于构建后续的扰动数据集,每个细胞系有500万个细胞,按照500个细胞重复,最终gRNA条数就是10,000条。
计算公式如下
6种细胞系×10,000条gRNA×500个细胞重复=30,000,000个细胞总数
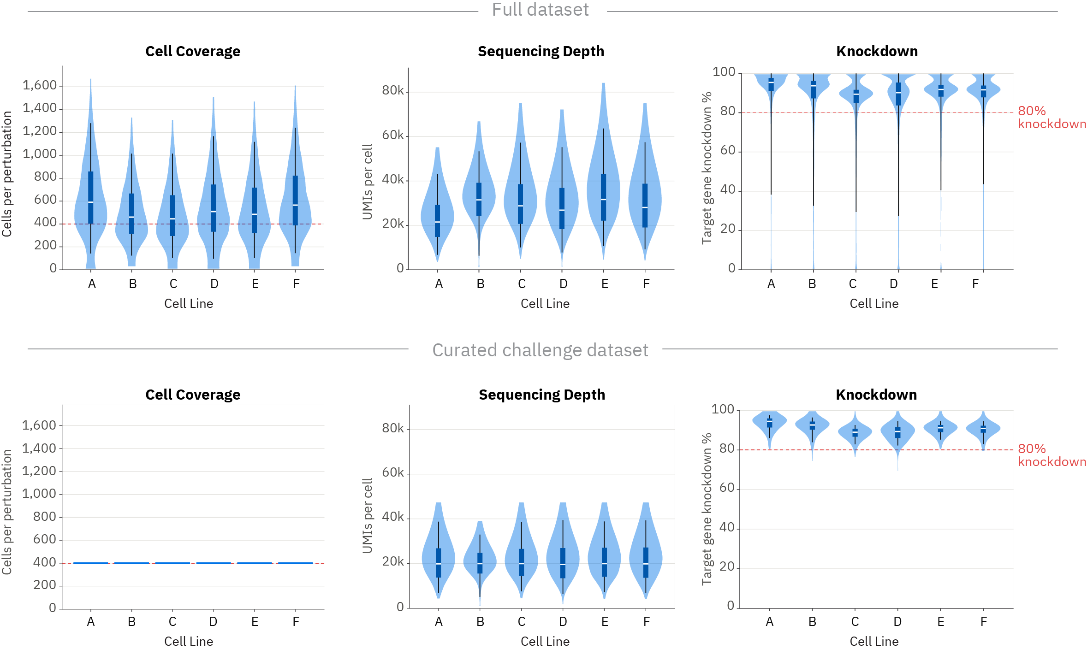
Arc进一步选择了能产生至少80%靶基因降低表达的扰动,并对每个扰动的400个细胞进行后续分析。
为了达到每个细胞至少有20,000个UMI,Arc对这30M个细胞进行了测序,产生了总计800B条reads,折算下来每个细胞至少平均有26,667条reads,按照sgRNA需要分配5,000条reads来看,mRNA文库在21,000条reads左右,这个与前面的VCC 2026 平均29,482条reads数是相吻合的。
如此庞大的数据量,Arc还专门开发了cyto这个分析pipeline专门用于处理海量10x Flex数据的分析流程。
为了构建具有上下文泛化任务虚拟细胞模型,事实上所需的数据量是极其庞大的!这6个细胞系只是冰山一角,Arc及其领域的其他研究人员将继续大规模构建因果数据,以驱动这些模型。
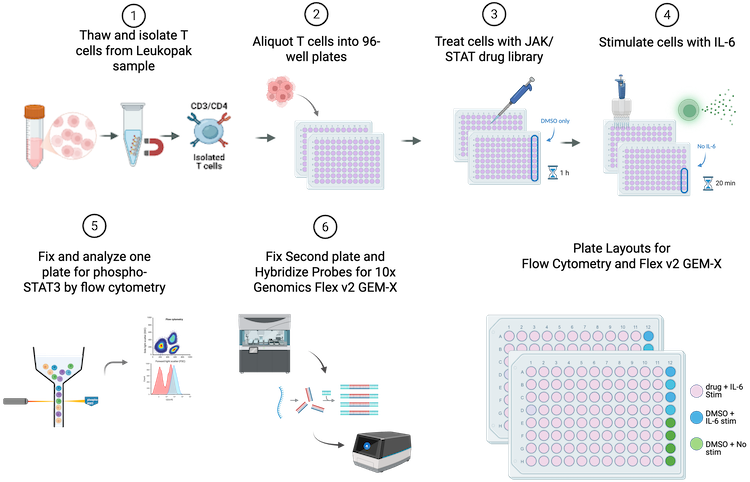
虽然Arc目前只专注于基因扰动,但是其他扰动研究也开始出现,如艾伦研究所聚焦细胞因子信号传导扰动(环境因子一种)来研究T细胞中IL-6信号抑制剂的药物开发研究,使用的也是10x Flex技术。
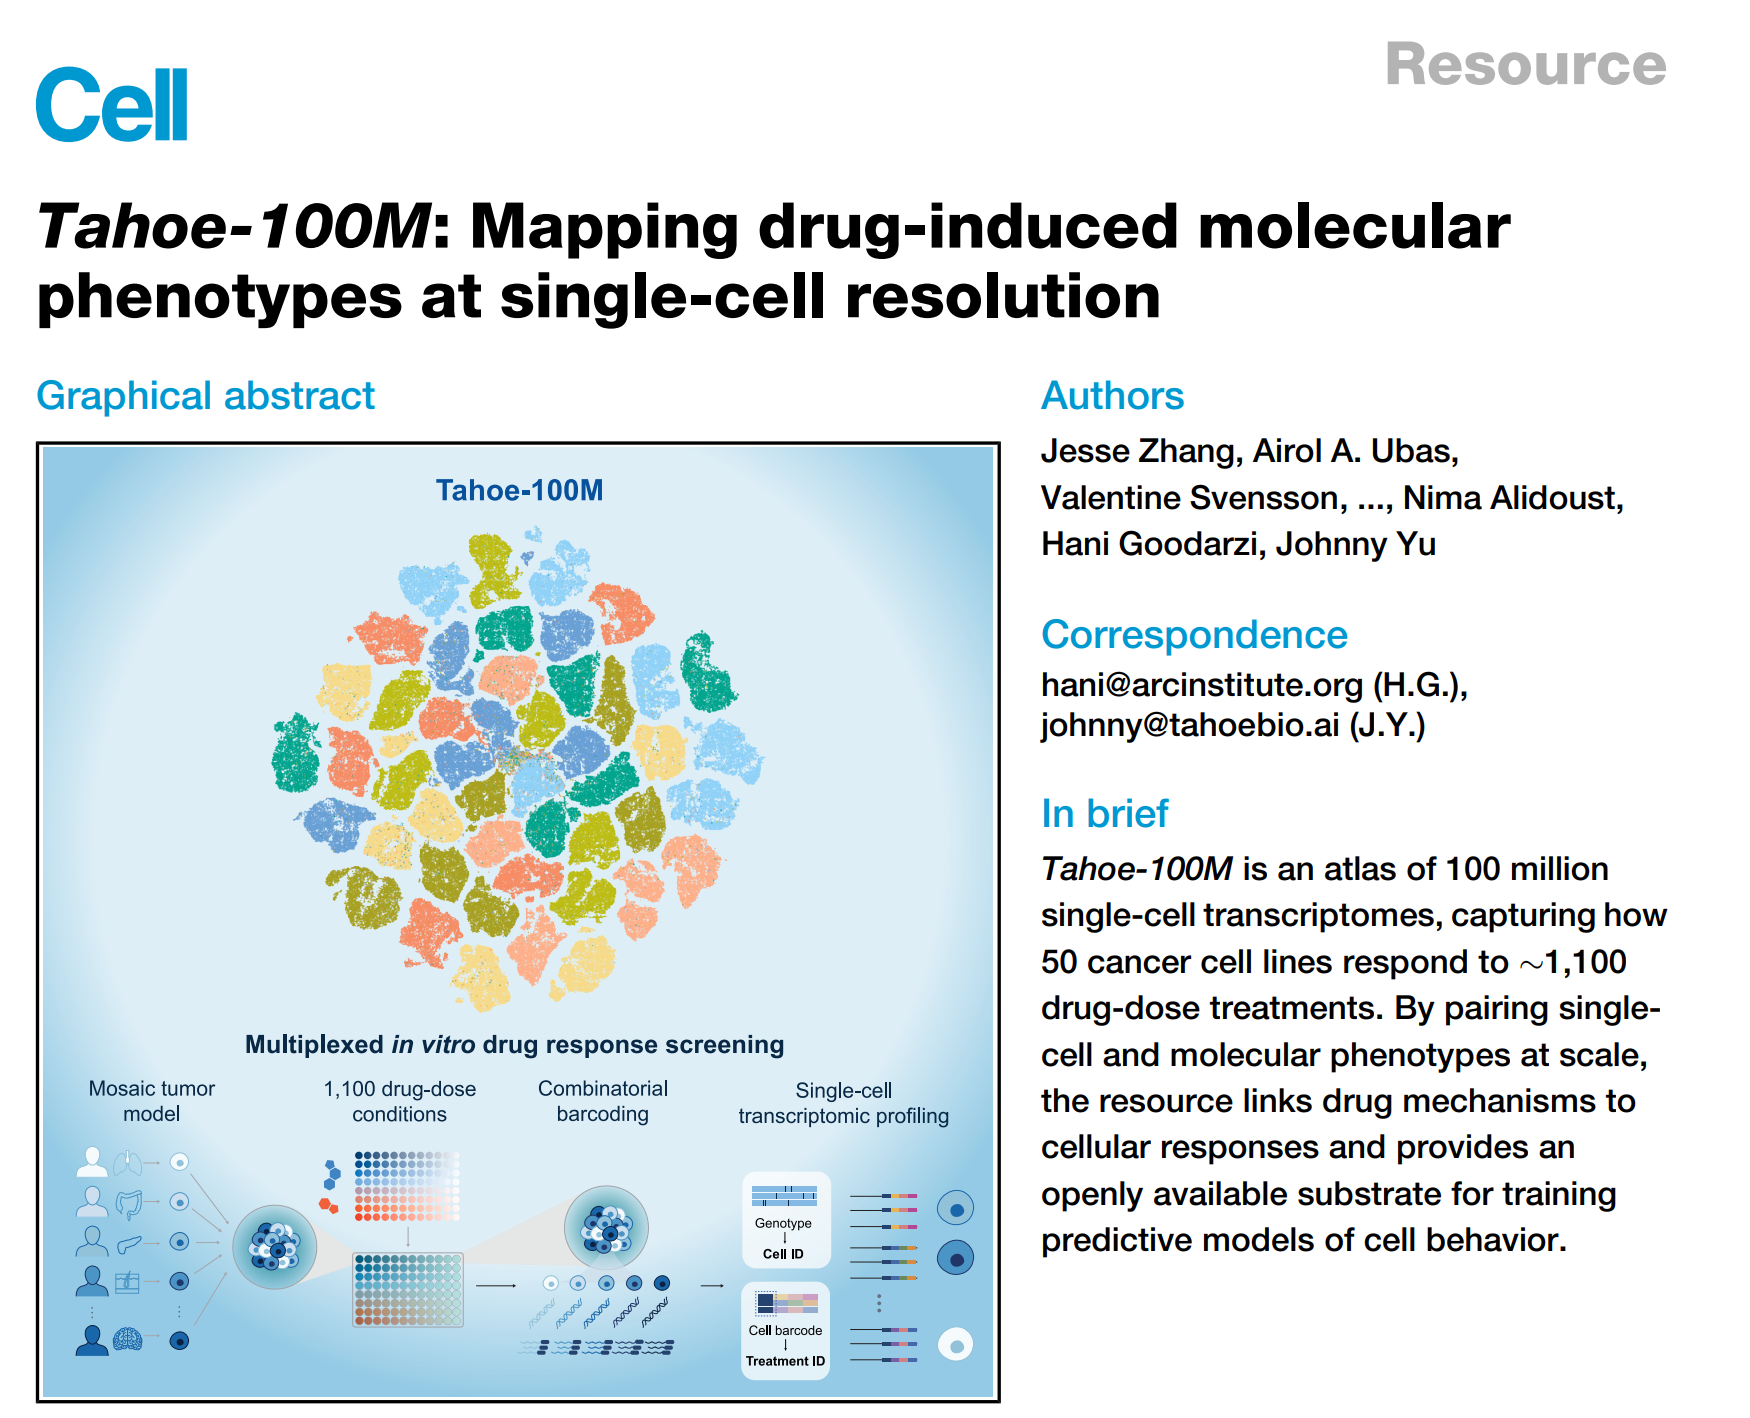
此外还有大名鼎鼎的Tahoe-100M化学扰动,主要是小分子药物研究方向。
这些AI虚拟细胞的建模工作将持续不断发展,随着Arc从模型算法团队获得实时反馈,后续的实验策略和路径也会随之演变。因此接下来,Arc将优化模型学习与数据生成之间的迭代方式,从而更接近真实的“lab-in-the-loop”体系。
未来虚拟细胞AIVC还有很长的路要走,让我们再次恭喜illumina之外,也要知道这个领域接下来的挑战依旧很多,整个行业需要更多高质量的数据来证明AIVC的价值与威力。行业是否也会迎来属于虚拟细胞的GPT-3时刻?让我们拭目以待!
拓展阅读:万字长文:AIVC虚拟细胞的GPT-3时刻会是什么样?对话Arc联合创始人